一張排班表排得很漂亮:每個時段都有人,空檔很少,人力成本也下降了。直到有人問,為什麼接孩子的人總被排到最後一班?表格沒有算錯。只是被算進去的事情,從一開始就不完整。
願景很大,問題藏在「人類」兩個字裡
Sam Altman在2023年2月署名的AGI規劃文章裡,描繪能大幅增強人類能力的AI願景,同時提出利益、使用機會與治理應廣泛分享。這是一份願景與方向,並非成果已經實現的證明。
同年7月,OpenAI由Jan Leike與Ilya Sutskever署名提出「超級對齊」研究計畫,追問如何讓遠比人類聰明的系統遵循人類意圖。當時提出以AI協助評估等研究路線,也明說沒有成功保證。這裡談的是2023年的提案,不能據此推定後來的團隊狀態或問題已解決。
技術上的可靠控制,與社會上由誰決定目標,彼此相關,卻不是同一道題。即使系統能精確照做,我們仍得問:它照的是誰的意思?
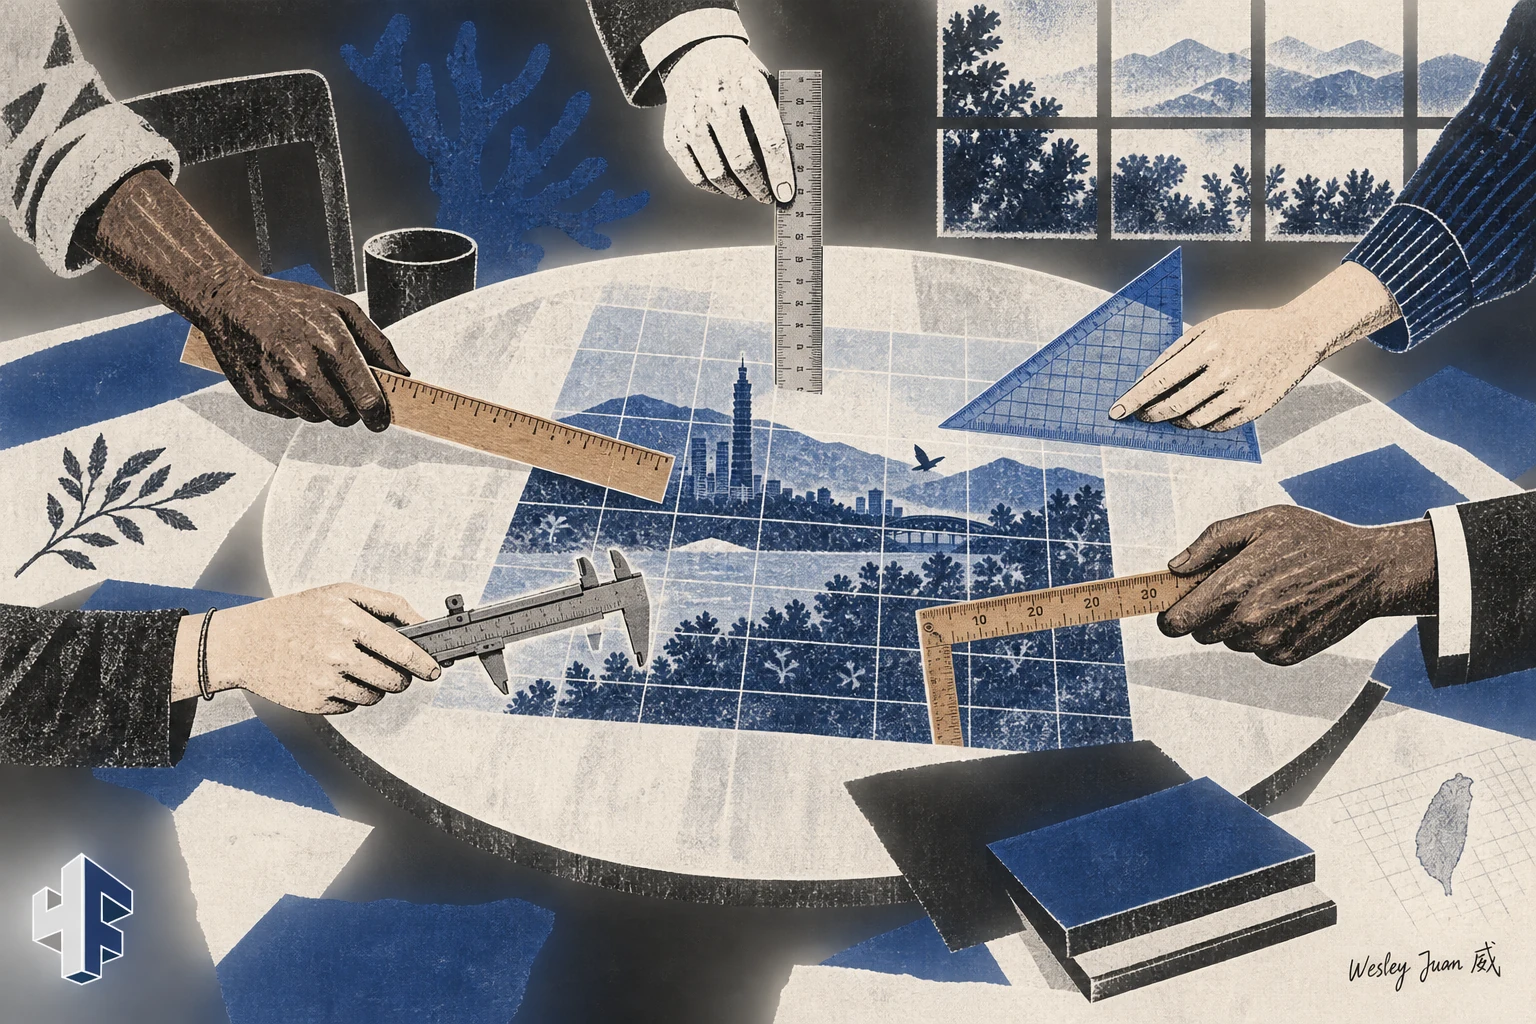
同一張表,放著幾把不同的尺
回到一個假想的小店。店長希望尖峰不缺人,員工希望休息日可預期,有人需要配合照顧安排,也有人想多排班增加收入。把全部需要塞進一句「排得公平一點」,不會讓分歧自動消失。
若每個人值晚班次數相同,算公平嗎?若依個別限制調整,其他人又是否承擔了更多不方便?這些問題不能只靠把計算速度加快來回答。
工具可以列出不同方案的後果,讓取捨更清楚;但「哪一種負擔可以由誰承擔」,仍需要讓受影響的人參與。提出目標的人,也應說明自己用了什麼標準。
把自己的尺說清楚,也讓被衡量的人有機會開口。
帶回 Mental Gym:先列目標,再找不能被交換的事
對練時,可以替一個決定畫三欄:希望增加什麼、哪些界線不能為了成績而跨過,以及誰有機會提出異議。
排班的目標可能是服務順暢,界線可能是事先約定的休息與不可上班時段,異議機制則可以是排定前確認、出錯後能調整。這些具體安排,才讓「尊重每個人」不只留在宣言裡。
接著試問:如果只把目標做得更好,誰可能反而更辛苦?若答案裡出現一位從未參與討論的人,就先停下來聽他說明。自己的尺可以清楚,卻不必因此成為量遍所有人的唯一尺度。
有自己的標準,也留下修改的入口
協商不保證所有人滿意,更不表示基本權益可以交給多數人投票取消。不同意見之間,需要交代底線、決定權與責任,而不是把每個衝突都平均分配。
也有些要求無法同時滿足。此時與其讓工具替決策者背書,不如坦白說出取捨:這次優先了什麼、代價落在哪裡,以及什麼條件改變後會重看。
AI把一個古老的問題放大了:我們想把事情做好,但「好」從來不只住在下指令的人心裡。讓答案可以被追問、讓受影響的人有回應的位置,也許就是我們今天已經能開始練習的對齊。
挑一項會影響他人的安排,列出目標、不能交換的界線、提出異議的入口;檢查有誰承擔代價,卻尚未參與。
留下一個自己的版本。
只存於此瀏覽器,不會送出。換裝置不會同步;清除瀏覽資料會移除紀錄。
延伸閱讀與資料來源
- Sam Altman:Planning for AGI and beyond(2023) ↗
2023年2月24日願景文章;本文只取能力、利益分享與治理提問,不沿用文中已標示過時的組織結構資訊。
- Jan Leike、Ilya Sutskever:Introducing Superalignment(2023) ↗
2023年7月5日歷史研究提案,區分技術上的意圖遵循與更廣的社會治理問題;不代表現況或已完成。
同一個問題,繼續聊。
這個主題的影片尚未上架。先留一個自己的版本,之後再回來看看。